
Monitoruj aplikację za pomocą alertów monday code
Alerty monday code pomagają monitorować aplikacje backendowe i wykrywać problemy, zanim wpłyną na użytkowników końcowych. Wystarczy kilka kroków, aby skonfigurować alerty i wyświetlać je na jednej, centralnej tablicy monday.com. Znajdziesz na niej kontekst, znaczniki czasu i informacje regionalne.
Na tej tablicy możesz tworzyć przepływy pracy, które powiadamiają właściwe osoby, przypisują odpowiedzialność i integrują się z używanymi przez Ciebie narzędziami. Dzięki temu aplikacja działa sprawnie, a reagowanie na incydenty jest skuteczniejsze.
Alerty monday code zapewniają:
- Wczesne ostrzeżenia o problemach z wydajnością i przekroczeniu limitów czasu działania
- Automatycznie generowaną, centralną tablicę alertów ze znacznikami czasu i informacjami regionalnymi
- Natywne integracje umożliwiające wysyłanie powiadomień Slack, przypisywanie alertów lub integrację z zewnętrznymi narzędziami
- Kontekst techniczny przydatny dla deweloperów, zawierający konkretne dane, na podstawie których można podjąć działania
Typy alertów
monday code obsługuje obecnie trzy typy alertów:
| Typ alertu (Alert Type) | Co monitoruje (What It Monitors) | Przykłady zastosowania (Use Cases) |
|---|---|---|
| Wskaźnik błędów HTTP (HTTP error rate) | Odsetek żądań HTTP, które w określonym przedziale czasu zwracają kody błędów (np. 4xx, 5xx) | • Wykrywanie nagłego wzrostu liczby błędów • Monitorowanie niezawodności punktów końcowych API • Śledzenie ogólnego stanu aplikacji |
| Opóźnienie odpowiedzi HTTP (HTTP latency response) | Odsetek czasów odpowiedzi przekraczających ustawiony próg opóźnienia | • Monitorowanie wpływu zmian w kodzie • Zapewnienie zgodności z umową SLA • Wczesne wykrywanie pogorszenia wydajności |
| Limit czasu działania (Runtime limit) | Limit dziennego czasu wykonywania żądań (Daily runtime execution limit) | • Zapobieganie blokowaniu usługi • Monitorowanie trendów zużycia zasobów • Planowanie przepustowości na okresy wzmożonego ruchu |
Jak skonfigurować alerty
Utwórz alert
- Otwórz aplikację w Centrum deweloperskim (Developer Center).
- Przejdź do Hostuj w monday (Host on monday).
- Kliknij Kod po stronie serwera (Server-side code).
- Wybierz kartę Zasady alertów (Alert policies).
- Kliknij Utwórz alert (Create alert).
Skonfiguruj alert
- Jeśli nie masz jeszcze tablicy alertów, wybierz obszar roboczy (workspace), w którym chcesz ją utworzyć.
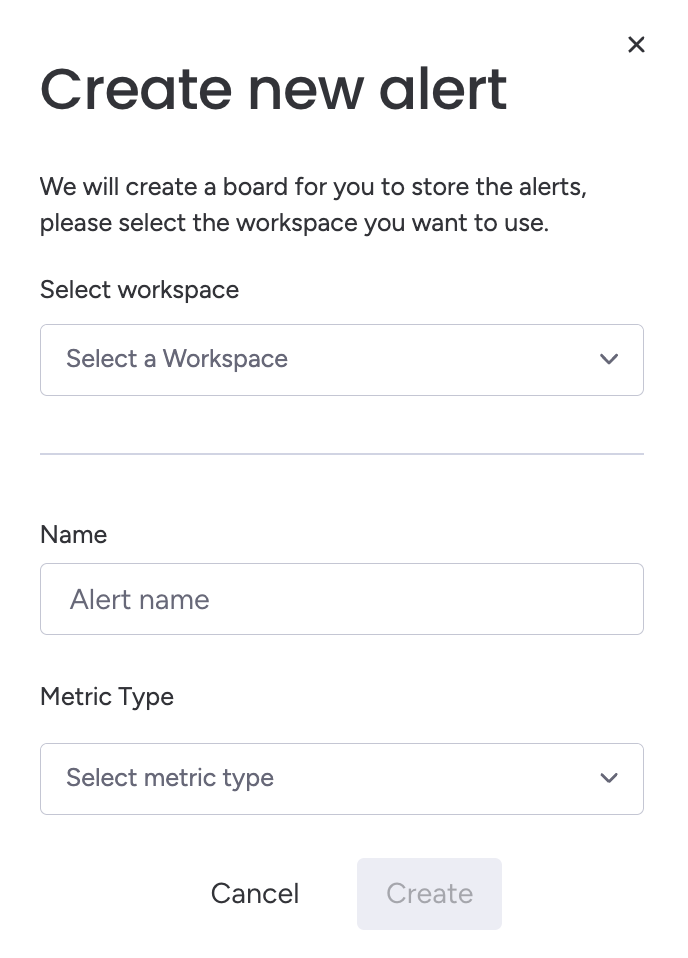
- Wpisz opisową nazwę.
- Wybierz typ alertu z menu Typ wskaźnika (Metric Type).
- Skonfiguruj parametry:
| Typ alertu | Opis | Zalecana konfiguracja |
|---|---|---|
| Wskaźnik błędów HTTP | • Próg powyżej (%) (Threshold above (%)): odsetek błędów (np. 5% oznacza, że 5 na 100 żądań kończy się błędem) • Przedział czasu (minuty) (Time window (minutes)): okres oceny |
• Próg powyżej (%): 1–5% • Przedział czasu (minuty): 10–15 minut |
| Opóźnienie odpowiedzi HTTP | • Próg powyżej (ms) (Threshold above (ms)): maksymalny akceptowalny czas odpowiedzi • Percentyl (Percentile): jaki odsetek żądań może przekroczyć próg • Przedział czasu (minuty): okres oceny |
• Próg powyżej (ms): 2000–5000 ms • Percentyl: 95% • Przedział czasu (minuty): 10 minut |
| Limit czasu działania | • Próg powyżej (%) (Threshold above (%)): odsetek wykorzystanego dziennego limitu czasu wykonywania żądań • Limit zależy od typu aplikacji i liczby stanowisk. Przeczytaj dokumentację, aby dowiedzieć się, jak go obliczyć. |
• Próg powyżej: 80% dziennego limitu czasu działania |
Zarządzaj alertami
- Włącz lub wyłącz alerty: użyj przełącznika Aktywny (Active).
- Edytuj istniejące alerty: kliknij alert, wprowadź zmiany i kliknij Zapisz (Save).
- Usuń alert: kliknij alert i wybierz Usuń (Delete).
Sprawdzone metody
Reagowanie na alerty
- Szybko potwierdź alert i zaktualizuj jego status, aby wskazać, że sprawdzasz problem
- Zapisz swoje ustalenia w sekcji aktualizacji na tablicy alertów
- Ustal źródłową przyczynę problemu, aby zrozumieć, dlaczego pojawił się alert
- Zaktualizuj instrukcje postępowania, aby zapisać rozwiązanie na przyszłość
- Dostosuj czułość alertów do wzorców fałszywych alarmów
Dostosowywanie progów
Zalecamy zacząć od wyższych progów, aby ograniczyć liczbę nieistotnych alertów. Monitoruj wyniki przez 1–2 tygodnie, aby ustalić punkt odniesienia, a następnie stopniowo obniżaj progi, gdy rozpoznasz typowe wzorce. Pamiętaj o sezonowych korektach uwzględniających cykle biznesowe i wzorce ruchu.
Strategie badania problemów
Zalecamy podejście 80/20: najpierw skup się na najczęstszych źródłach problemów.
| Typ alertu | Pierwsze kroki | Częste źródła problemów | Kolejne kroki |
|---|---|---|---|
| Wskaźnik błędów HTTP | Sprawdź na tablicy alertów wzorce dotyczące czasu i regionów | • Ostatnie wdrożenia • Wąskie gardła w bazie danych • Zewnętrzne interfejsy API |
Sprawdź dzienniki w Centrum deweloperskim, aby poznać szczegóły błędów |
| Opóźnienie HTTP | Użyj monitorowania w Centrum deweloperskim, aby znaleźć punkty końcowe, których dotyczy problem | • Wolne zapytania • Spowolnienia działania usług zewnętrznych |
• Sprawdź ostatnie zmiany w kodzie • Zoptymalizuj zapytania |
| Limit czasu działania | Sprawdź użycie aplikacji w analityce Centrum deweloperskiego | • Niekontrolowane procesy lub nieskończone pętle • Punkty końcowe zużywające dużo zasobów |
• Zoptymalizuj aplikację za pomocą pamięci podręcznej i zapytań • Opracuj strategię skalowania |